GPU 程序常常反复执行同一组 kernel。单个 kernel 的优化很重要,kernel 之间的决策同样重要:哪些启动需要等待,哪些分支可以重叠,哪些临时缓冲区可以共享存储,以及一次主机提交应该包含多少工作。
CKL(Composable Kernel Language)尝试把这些决策纳入一门小型 MLIR 语言。编译器同时看到设备计算和组合它们的程序,根据内存效应推导依赖图,依据图规划临时存储,再生成可复用执行计划。
Kernel 组合与编排
考虑一个启动三个 kernel 的命令式程序:
A: update(input_a, temporary_a)
B: update(input_b, temporary_b)
C: combine(temporary_a, temporary_b, output)
如果已知 A、B 使用的资源互不重叠,执行图为:
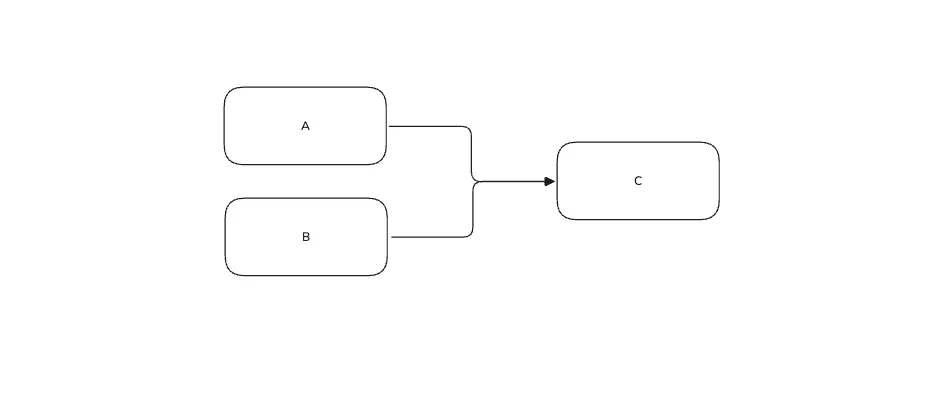
资源允许时,A、B 并发更高效,但 C 必须等待二者完成。手工管理这些依赖并编码为 CUDA Graph,繁琐且难以维护。
Stream、CUDA Graph 与编译器推导的依赖
CUDA stream 为操作提供顺序,多 stream 与 event 可以表达跨 stream 依赖。CUDA Graph 显式表示工作和依赖,支持复用执行,既可直接构建,也可通过 stream capture 录制。参见 CUDA Graph 编程指南。
这些机制执行应用提供的依赖;CKL 编译器负责从程序的效应与别名分析中推导依赖,构建显式图。
IREE 提供了更完整的编译器架构参考,其 Stream 方言在高层计算与硬件抽象层之间显式表示资源、异步工作、时间点和命令执行。CKL 借鉴类似思想,构建更小的执行规划层。之后会另文比较两者。
Kernel 组合的收益
存在几个相互独立的机会:
| 机会 | 改变什么 | 所需依据 |
|---|---|---|
| 依赖调度 | 独立 kernel 无需多余顺序约束即可就绪 | 完整效应与可靠别名信息 |
| 临时存储复用 | 不同逻辑缓冲区共享物理存储 | 各生命周期内所有访问有序 |
| 图重放 | 复用已绑定命令图 | 资源、参数和拓扑稳定 |
| 步骤分组 | 一次提交包含多个完整迭代 | 迭代间依赖正确 |
| Kernel 融合 | 多段设备计算合为一个 kernel | 保持计算与内存语义的变换 |
这些机会可能相互冲突。存储复用不能让原本独立的分支产生竞争;迭代分组必须保留可变状态依赖;融合会改变设备计算,甚至改变内存操作本身。CKL 主要关注依赖调度和临时存储复用。
Composable Kernel Language
IREE 等系统已经为这个问题提供完整编译器与运行时。这里想回答的是:能否用最小的一组 MLIR 接口和 pass,让小型 GPU DSL 更容易获得组合能力,而不采用整套编译器栈?目前 CKL 是自包含语言,负责 kernel、程序 IR、ABI 元数据、设备降级和运行时交接。接口提供了内部边界,但仓库尚无适配任意外部 DSL kernel 的通用 adapter,因为定制运行时需要大量接线。不过,接口、分析和变换的模式应可被其他 MLIR DSL 借鉴。
示例程序
下面的 CKL 程序将同一个 kernel 使用两次:
import ckl

N = ckl.dim("N")
Vector = ckl.Buffer[ckl.f32, (N,)]

@ckl.kernel
def update(src: Vector, dst: Vector, bias: ckl.f32) -> None:
    i = ckl.global_id(0)
    if i < src.shape[0]:
        dst[i] = src[i] + bias

@ckl.program
def step(src: Vector, dst: Vector, bias: ckl.f32) -> None:
    temporary = ckl.empty_like(src)
    grid = (ckl.cdiv(src.shape[0], 256),)
    ckl.launch(update, src, temporary, bias, grid=grid, block=(256,))
    ckl.launch(update, temporary, dst, bias, grid=grid, block=(256,))

lowered = step.lower(signature={
    "src": ckl.BufferSpec((257,), ckl.f32),
    "dst": ckl.BufferSpec((257,), ckl.f32),
    "bias": ckl.f32,
})
kernel 描述设备计算,program 描述分配和组合,即 driver。先计算 temporary = src + bias,再计算 dst = temporary + bias。长度特化为 257,每次启动两个 256 线程 block,并显式保护多余线程。这种反复执行小 kernel 的模式在科学计算中很常见,例如三维电磁时域有限差分。
架构概览
当前流水线包含共享准备阶段,以及分离的主机、设备分支:
Python kernel + program ASTs
    │  signature checking and specialization
    ▼
CKL IR + upstream arith/scf operations
    │  optional pointwise fusion
    │  ckl-prepare-cuda
    ├─────────────────────────────────────────────┐
    ▼                                             ▼
ckl-build-graph                          ckl-lower-kernels-to-gpu
  ├─ recompute effect summaries                   │
  ├─ bind aliases and dispatch effects            ▼
  ├─ infer dependency graph                upstream GPU/NVVM lowering
  └─ attach static memory plan                    │
    │                                             ▼
    ▼                                           CUBIN
ckl-lower-graph-to-exec                           │
    │                                             │
    ▼                                             │
verified ckl_exec.plan + source signature ◄───────┘
    │  embed device bytes in a dedicated host module
    ▼
ckl-lower-exec-to-llvm
    │
    ▼
MLIR LLVM dialect → upstream translation → ExecutionEngine
    │
    ▼
JIT entry constructs a bound native plan
    │
    ▼
ordinary launches / captured graph / inferred graph
核心概念与实现
基础操作
操作定义位于 CKLOps.td。
| 操作 | 输入 → 输出 | 含义与当前范围 |
|---|---|---|
ckl.alloc | 静态 memref 结果类型 → 缓冲区 | 编译器管理的设备分配 |
ckl.free | 缓冲区 → 无 | 结束编译器管理的资源生命周期 |
ckl.load_element | 缓冲区、各维索引 → 标量 | 索引读取;常量索引暴露单元素,否则覆盖整个操作数 |
ckl.store_element | 标量、缓冲区、索引 → 无 | 索引写入;常量索引暴露单元素,否则覆盖整个操作数 |
ckl.thread_id、ckl.block_id | 轴属性 → index | 线程、线程块坐标 |
ckl.block_dim、ckl.grid_dim | 轴属性 → index | block、grid 大小 |
ckl.global_id | 轴属性 → index | block_id * block_dim + thread_id |
ckl.view | 缓冲区 → 同类型缓冲区 | 不分配、不复制的恒等别名 |
ckl.subview | 缓冲区、静态元素偏移 → 连续视图 | 保留基资源身份,暴露有界字节区间 |
ckl.load、ckl.store | 缓冲区/标量 → 标量/无 | 低层测试中的整资源分析操作 |
ckl.atomic_rmw | 值、缓冲区、顺序/作用域 → 值 | 分析用原子读写效应 |
ckl.sync | 资源、作用域 → 无 | 分析用同步和资源顺序元数据 |
ckl.dispatch | 参数、可选完成 token、启动元数据 → token | 可调度 kernel 调用 |
ckl.graph | 源函数、图元数据 → 区域 | 承载分析节点、边和内存计划属性 |
内存效应
Load 读取内存,store 修改内存,分配与释放改变资源生命周期。这些操作为 kernel 执行施加顺序。例如,读取临时结果的消费者必须在写入该结果的生产者之后执行。
CKL 基于 MLIR 的 MemoryEffectOpInterface,索引加载的简化定义为:
def CKL_LoadElementOp : CKL_Op<"load_element", [AccessRegionOpInterface]> {
  let arguments = (ins
    Arg<AnyMemRef, "", [MemReadAt<0, FullEffect>]>:$resource,
    Variadic<Index>:$indices);
  let results = (outs AnyType:$value);
  let hasVerifier = 1;
}内存效应标注指出资源操作数关联的读取,定制访问区域接口补充受影响的资源范围。结合两者,才能知道发生什么访问,以及可能发生在哪里。
AccessRegionOpInterface 基本通过 getOperationAccessRegion 辅助函数实现:
/*
def AccessRegionOpInterface : OpInterface<"AccessRegionOpInterface"> {
  let cppNamespace = "::mlir::ckl";
  let methods = [
    InterfaceMethod<
      "Returns whole, unknown, or a byte interval relative to the accessed operand.",
      "::mlir::Attribute", "getAccessRegion",
      (ins "::mlir::Value":$resource), [{}], [{
        return ::mlir::ckl::getOperationAccessRegion($_op, resource);
      }]>
  ];
}
*/
Attribute mlir::ckl::getOperationAccessRegion(Operation *op, Value resource) {
  /*
  e.g. for ckl.load_element %r[%i, %j, %k], the access region is
  %i * stride[0] + %j * stride[1] + %k * stride[2] * sizeof(element)
  */
  auto type = dyn_cast<MemRefType>(resource.getType());
  StringRef name = op->getName().getStringRef();
  if (type && type.hasStaticShape() && type.getLayout().isIdentity() &&
      type.getElementType().isIntOrFloat() &&
      type.getElementType().getIntOrFloatBitWidth() % 8 == 0 &&
      (name == "ckl.load_element" || name == "ckl.store_element")) {
    unsigned begin = name == "ckl.load_element" ? 1 : 2;
    int64_t linear = 0;
    for (int64_t axis = 0; axis < type.getRank(); ++axis) {
      // Compute the linear index of the accessed element. If any of the indices are
      // not constant, or out of bounds, return "whole" to indicate that the entire
      // resource may be accessed.
      APInt index;
      if (!matchPattern(op->getOperand(begin + axis), m_ConstantInt(&index)))
        return StringAttr::get(op->getContext(), "whole");
      int64_t i = index.getSExtValue(), extent = type.getDimSize(axis);
      if (i < 0 || i >= extent || linear > (std::numeric_limits<int64_t>::max() - i) / extent)
        return StringAttr::get(op->getContext(), "whole");
      linear = linear * extent + i;
    }
    int64_t bytes = type.getElementType().getIntOrFloatBitWidth() / 8;
    if (bytes && linear <= std::numeric_limits<int64_t>::max() / bytes)
      return byteRange(op->getContext(), linear * bytes, bytes);
  }
  return StringAttr::get(op->getContext(), "whole");
}
常量索引的 load/store 暴露单元素字节区间,其他索引保守覆盖整个操作数。结果是 Attribute:"whole"、"unknown",或包含字节 offset、length 的字典。分析通过受支持的连续 subview 组合区间,并将多次访问合并为保守包围区间。
为 Kernel 生成摘要
EffectAnalysis.cpp 包含 SummaryAnalysis 和 SummarizeEffectsPass。示例 kernel 的逻辑摘要为:
update(src, dst, bias):
  src  → read, whole buffer
  dst  → write, whole buffer
  bias → no memory effect
生成属性形如:
ckl.effect_summary = {
  accesses = [
    {arg = 0 : i64, effects = ["read"], region = "whole"},
    {arg = 1 : i64, effects = ["write"], region = "whole"}
  ],
  may_alias = [[0, 1]],
  ordering_scopes = [],
  synchronizes = false,
  unknown = false
}
may_alias = [[0, 1]] 记录两个缓冲区形参在调用者绑定时可能重叠,后文会讨论。标量 bias 不包含资源访问项。摘要基于形式参数描述 kernel,每次 dispatch 仍需替换为实际缓冲区。
实现遍历函数体和嵌套区域,获取内存效应实例,将每个被访问值追溯到基资源,再累加到相应形参。对于函数调用,递归总结被调函数,将实参代入形参,再将效应累加到调用方。
if (auto interface = dyn_cast<MemoryEffectOpInterface>(operation)) {
  SmallVector<MemoryEffects::EffectInstance> effects;
  interface.getEffects(effects);
  // For each effect, classify its kind and resolve its resource.
}

if (auto regionInterface = dyn_cast<AccessRegionOpInterface>(operation)) {
  Attribute region = regionInterface.getAccessRegion(value);
  // Compose through supported views and merge into the argument summary.
}
之后 ckl-build-graph 通过 deriveEffectSummaries 使用摘要构建执行图。
别名分析
两个 SSA 值可能引用同一次底层分配:
%base = "ckl.alloc"() : () -> memref<16xf32>
%alias = "ckl.view"(%base) : (memref<16xf32>) -> memref<16xf32>
通过 %alias 写入,会与之后通过 %base 读取冲突。只比较 SSA 名称会漏掉依赖。getBaseResource 沿 ViewLikeOpInterface 追溯原资源:
Value getBaseResource(Value value) {
  SmallPtrSet<Operation *, 8> visited;
  while (Operation *definition = value.getDefiningOp()) {
    if (!visited.insert(definition).second)
      break;
    auto view = dyn_cast<ViewLikeOpInterface>(definition);
    if (!view)
      break;
    value = view.getViewSource();
  }
  return value;
}
ckl.view 提供 getViewSource(),保留操作数类型,没有 offset、shape、stride 操作数,是恒等别名。其他上游 view-like 操作,包括 subview,也可在整缓冲区分析中追溯基资源。
别名分类很精简,主要将资源引用规范化为基资源。
lhs = getBaseResource(lhs);
rhs = getBaseResource(rhs);
if (lhs == rhs)
  return WholeBufferAliasResult::MustAlias;
if (isAllocationValue(lhs) || isAllocationValue(rhs))
  return WholeBufferAliasResult::NoAlias;
return WholeBufferAliasResult::MayAlias;
规范化后,相同资源必然别名,不同已知分配具有新鲜身份。不同外部参数仍可能别名,因为调用者可以传入重叠区间。图为 MustAlias 和 MayAlias 保留冲突,除非不相交访问区域能够证明可删除内存 hazard。
子视图
仅靠基资源别名无法区分同一缓冲区的不相交切片。ckl.subview 不分配或复制,却增加分析精度,暴露更多并行机会。偏移是源元素数量的常量,结果具有静态连续形状。例如使用前面的 update:
@ckl.program
def split_update(storage: Vector, output: Vector) -> None:
    left = ckl.subview(storage, offset=0, shape=(32,))
    right = ckl.subview(storage, offset=32, shape=(32,))
    ckl.launch(update, left, left, 1.0, grid=(1,), block=(32,))
    ckl.launch(update, right, right, 2.0, grid=(1,), block=(32,))
    ckl.launch(update, storage, output, 0.0, grid=(1,), block=(64,))

lowered = split_update.lower(signature={
    "storage": ckl.BufferSpec((64,), ckl.f32),
    "output": ckl.BufferSpec((64,), ckl.f32),
})
两个切片都规范化为 storage,因此基资源为 MustAlias,但访问字节半开区间不相交:left 为 [0, 128),right 为 [128, 256),所以编译器省略前两次启动之间的内存冲突边。
静态连续 CKL subview 可贯穿执行路径:参数描述符保留验证后的 byte_offset、byte_length,主机打包将偏移加到基址,kernel 在视图内从零索引。动态、跨步切片和未建模的上游 view 尚不支持执行。临时 subview 保留基分配的生命周期和存储规划身份,不构成独立分配。
图规划
BuildGraphPass 首先将每次 dispatch 的 kernel 形式效应绑定到实际资源。示例中:
launch 0: read(src),       write(temporary)
launch 1: read(temporary), write(dst)
temporary 上的写读冲突建立生产者到消费者的边。对于潜在别名资源,基本 hazard 为:
| 较早访问 | 较晚访问 | 顺序要求 |
|---|---|---|
| 读 | 读 | 无内存冲突边 |
| 写 | 读 | 保留生成值:RAW |
| 读 | 写 | 避免消费前覆盖:WAR |
| 写 | 写 | 保留写入顺序:WAW |
| 分配/释放 | 冲突访问 | 保留资源生命周期 |
构图器比较先后节点及其绑定访问,冲突判断基本为:
WholeBufferAliasResult alias = aliasWholeBuffers(lhs.resource, rhs.resource);
if (alias == WholeBufferAliasResult::NoAlias ||
    !hasConflictingAccesses(lhs.bits, rhs.bits))
  continue;
bool lifetime = ((lhs.bits | rhs.bits) & (Allocate | Free)) != 0;
if (!lifetime && alias == WholeBufferAliasResult::MustAlias &&
    areDisjointAccessRegions(lhs.region, rhs.region))
  continue;
// Add an edge and retain its reason.
存储规划:复用遵循图顺序
源码中的顺序区间不足以证明存储可复用。两个分支在源码中前后出现,推导图中却可能并发执行。
设 U(A) 是推导效应访问资源 A 的全部 dispatch 节点。图到规划器的桥接收集这些用户,并在包含生命周期节点的图上计算可达性。只有满足以下条件,才允许 A 的存储先于 B 被复用:
for every a in U(A) and every b in U(B):
    a != b and there is a dependency path a → b
只要 A 的一个用户仍可能与 B 的某个用户并行,就不能共用槽位。合法有序示例如下:
allocate A → produce A → consume A → free A
                                         │
                                         ▼
                              allocate B → produce B → consume B → free B
MemoryPlanner.cpp 使用 Floyd–Warshall 计算传递可达性,并检查所有用户对。这是三次时间、二次存储的直接闭包实现,适合当前小图,不是可扩展最优分配算法。
分配器贪心选择兼容槽位中容量增长最小的一个。共享槽位扩大到能容纳最大成员及其对齐要求,随后按设备和地址空间打包到 heap。外部缓冲区不由计划分配,持久资源不参与回收。临时资源必须与槽位每个既有成员之间都有明确前后关系。
关键不变量是:存储规划不增加依赖来强迫复用,图拓扑保持不变。若要以串行化换更小 heap,那是需要独立测量的另一项优化。
报告保留基线字节数、规划字节数、分配关系和复用原因。动态形状或不支持布局会返回带原因诊断的不可用计划,不会凭空计算字节数。
从分析到执行
经验证的可执行计划
LowerGraphToExecPass 根据内存计划建立 ABI:
- 确定一个后端,将图依赖投影到 dispatch 节点。
- 具体化 heap 及具名外部、临时资源绑定。
- 将逻辑参数转换为物理 ABI 槽位。
- 生成带显式启动几何、产物身份、ABI 和前驱 ID 的 kernel 项。
ckl_exec 方言 使这些决策可检查:
| 操作 | 职责 |
|---|---|
ckl_exec.plan | 持有后端就绪计划并引用源签名 |
ckl_exec.heap | 声明字节数、对齐、设备和地址空间 |
ckl_exec.resource | 绑定外部参数或临时 heap 切片 |
ckl_exec.kernel | 描述物理参数、启动几何、产物、ABI 和依赖 |
向量程序的资源与参数映射示意:
arg0                 → external src pointer
arg1                 → external dst pointer
arg2                 → f32 bias bytes
heap0 + offset 0     → temporary, 257 × sizeof(f32) bytes

kernel 0 arguments  → src, temporary, bias
kernel 1 arguments  → temporary, dst, bias
kernel 1 depends on → kernel 0
生成计划中,临时资源逻辑大小为 1,028 字节。规划器采用 256 字节对齐,因此 heap 为 1,280 字节,实际操作为:
"ckl_exec.heap"() <{
  address_space = "global", alignment = 256 : i64,
  bytes = 1280 : i64, device = 0 : i64, id = 0 : i64
}> : () -> ()
第二次 dispatch 的前驱为 dependencies = array<i64: 1>。第一次 dispatch 的图节点 ID 是 1,因为分配占据节点 0。移除生命周期节点后,可执行 kernel ID 仍保留原图身份,不重新连续编号。
设备降级与可选融合
ckl-prepare-cuda 验证 kernel 子集,设置设备、产物、实现及 ABI 元数据。ckl-lower-kernels-to-gpu 将 kernel 体克隆进 GPU 模块,用上游 memref/GPU 操作替换 CKL 索引访问和坐标。之后上游 GPU-to-NVVM 流水线生成 CUBIN。
主机降级与 JIT 生命周期
ExecToLLVM.cpp 实现 ckl-lower-exec-to-llvm。它接收专用主机模块,其中包含一个执行计划、源函数声明和嵌入二进制属性,生成 MLIR LLVM 操作,再由上游翻译为供 ExecutionEngine 使用的 LLVM IR。
生成入口的概念 ABI 为:
void ckl_entry(void *frame, void **arguments);它按既定顺序调用运行时辅助函数:
ckl_begin              load/cache the embedded device module
ckl_heap               allocate each planned temporary heap
ckl_resource           bind external pointers and heap slices
ckl_kernel             begin a launch description
ckl_argument_resource  append a physical resource pointer
ckl_argument_value     append physical scalar bytes
ckl_dependency         append predecessor IDs
ckl_commit             add the completed node to the bound plan
入口在 bind() 期间执行,构造计划而不启动 kernel。之后 run()、benchmark() 使用绑定计划和缓存图。
公共 Python 运行时封装基于 nanobind 原生对象,并支持上下文管理器:
with lowered.compile(target=target, fuse_pointwise=False) as program:
    with program.bind(src, dst, bias) as invocation:
        invocation.run(mode="ordinary")
        invocation.run(mode="capture")
        invocation.run(mode="graph")
MLIR Python execution engine 持有主机 JIT。注册的运行时符号引用会保留主机模块与 context,直到 engine 销毁。_jit.py 中的小型 ctypes.c_void_p adapter 只为上游注册 API 包装地址;CKL 运行时 API 本身通过 nanobind 暴露。
构建与重放 CUDA Graph
NvidiaRuntime.cpp 针对同一个原生 kernel 计划实现三种路径:
- 普通执行:按拓扑顺序遍历,在单一 stream 调用
cuLaunchKernel。 - Capture:开始 stream capture,录制普通启动,结束后实例化捕获图。
- 推导图:创建 CUDA Graph,为每个计划节点添加 kernel 节点及显式前驱,再实例化。
显式构图的核心为:
for (const NvidiaPlan::Node &node : plan.nodes()) {
std::vector<CUgraphNode> dependencies;
for (auto predecessor : node.dependencies)
dependencies.push_back(state->nodes.at(predecessor));
// Populate CUDA_KERNEL_NODE_PARAMS from this node's launch and packed arguments.
CUgraphNode graphNode{};
check(cuGraphAddKernelNode(&graphNode, state->graph,
dependencies.data(), dependencies.size(), ¶meters),
"cuGraphAddKernelNode");
state->nodes.push_back(graphNode);
}
check(cuGraphInstantiate(&state->executable, state->graph, 0), "cuGraphInstantiate");结果是可复用 CUgraphExec,通过调用 stream 上的 cuGraphLaunch 重放。重放期间不重新运行别名分析或存储规划。
评估
我们用小型 decoder 基准测试,观察在设备计算固定的前提下,改变执行计划能否改善完整且持续变化的 GPU 工作负载。
工作负载与测量设计
每个样本为每个请求连续生成 16 个 token。每步执行 embedding、RMSNorm、Q/K/V 投影、RoPE、KV cache 更新、因果 attention、MLP、最终归一化、词表投影、贪心选择、token 反馈和设备侧位置推进。选中 token 输入下一步,上下文持续增长,因此测试覆盖完整自回归计算。记录的 kernel 使用 FP32 和直接的逐线程串行点积/归约,没有 tensor core 或 FlashAttention。
机器配置为 16 GB NVIDIA RTX 5060 Ti、驱动 595.91.07、CUDA toolkit 12.8,以及面向 sm_120/+ptx87 的 Release CKL。测试配置如下:
| 用例 | Batch / 初始上下文 | 隐藏维度 / 头 / 层 | FFN / 词表 | 每步 Dispatch 数 |
|---|---|---|---|---|
| small | 1 / 8 | 64 / 4 / 2 | 128 / 256 | 48 |
| awkward | 3 / 3 | 48 / 3 / 1 | 80 / 129 | 27 |
| long_context | 1 / 512 | 64 / 4 / 2 | 128 / 256 | 48 |
| wide | 1 / 8 | 256 / 8 / 2 | 512 / 2048 | 48 |
| deep | 1 / 8 | 64 / 4 / 8 | 128 / 256 | 174 |
| large_vocab | 1 / 8 | 64 / 4 / 2 | 128 / 8192 | 48 |
| large_batch | 64 / 64 | 64 / 4 / 2 | 128 / 256 | 48 |
| batch4 | 4 / 8 | 64 / 4 / 2 | 128 / 256 | 48 |
| wide_batch4 | 4 / 8 | 256 / 8 / 2 | 512 / 2048 | 48 |
long_context、deep、large_vocab 分别只改变 small 的一项。wide 同时改变隐藏维度、头、FFN 和词表,代表更大配置,不用于单独研究宽度缩放。awkward 尺寸用于覆盖边界检查和非均匀形状。
计时分两层。原生 stream 时间用 CUDA event 包围完整 16 步并除以 16,包含原生提交引入的 GPU 间隙。Python 生成完成时间测量完整 16 步,每步或每组一次同步调用。图构建单独报告,因为其成本取决于绑定图能否反复复用。
结果概览
对每个用例测量三种方式:
- 普通基线每步通过一次原生 C++ 调用批量提交 kernel。
- Capture 录制单 stream 启动并重放相同顺序。
- 推导执行使用 CKL 效应和别名分析构建显式边,让独立分支同时就绪。 此外还把完整且相互依赖的多个解码步骤组合进大图,例如一次 CUDA Graph 启动生成后续 N 个 token。
| 用例 | 普通执行 µs/步 | Capture | 推导图 | 推导图,16 步分组 | 普通 / 推导 | Capture / 推导 |
|---|---|---|---|---|---|---|
| small | 62.08 | 54.82 | 46.71 | 45.40 | 1.33× | 1.17× |
| awkward | 34.93 | 28.01 | 24.58 | 23.06 | 1.42× | 1.14× |
| long_context | 177.08 | 171.64 | 163.60 | 161.91 | 1.08× | 1.05× |
| wide | 154.06 | 149.06 | 122.47 | 120.85 | 1.26× | 1.22× |
| deep | 230.72 | 194.67 | 162.48 | 161.76 | 1.42× | 1.20× |
| large_vocab | 215.23 | 209.68 | 201.58 | 200.22 | 1.07× | 1.04× |
| large_batch | 101.79 | 95.83 | 88.17 | 86.47 | 1.15× | 1.09× |
| batch4 | 63.67 | 55.31 | 47.47 | 46.14 | 1.34× | 1.17× |
| wide_batch4 | 159.40 | 154.15 | 128.48 | 126.72 | 1.24× | 1.20× |
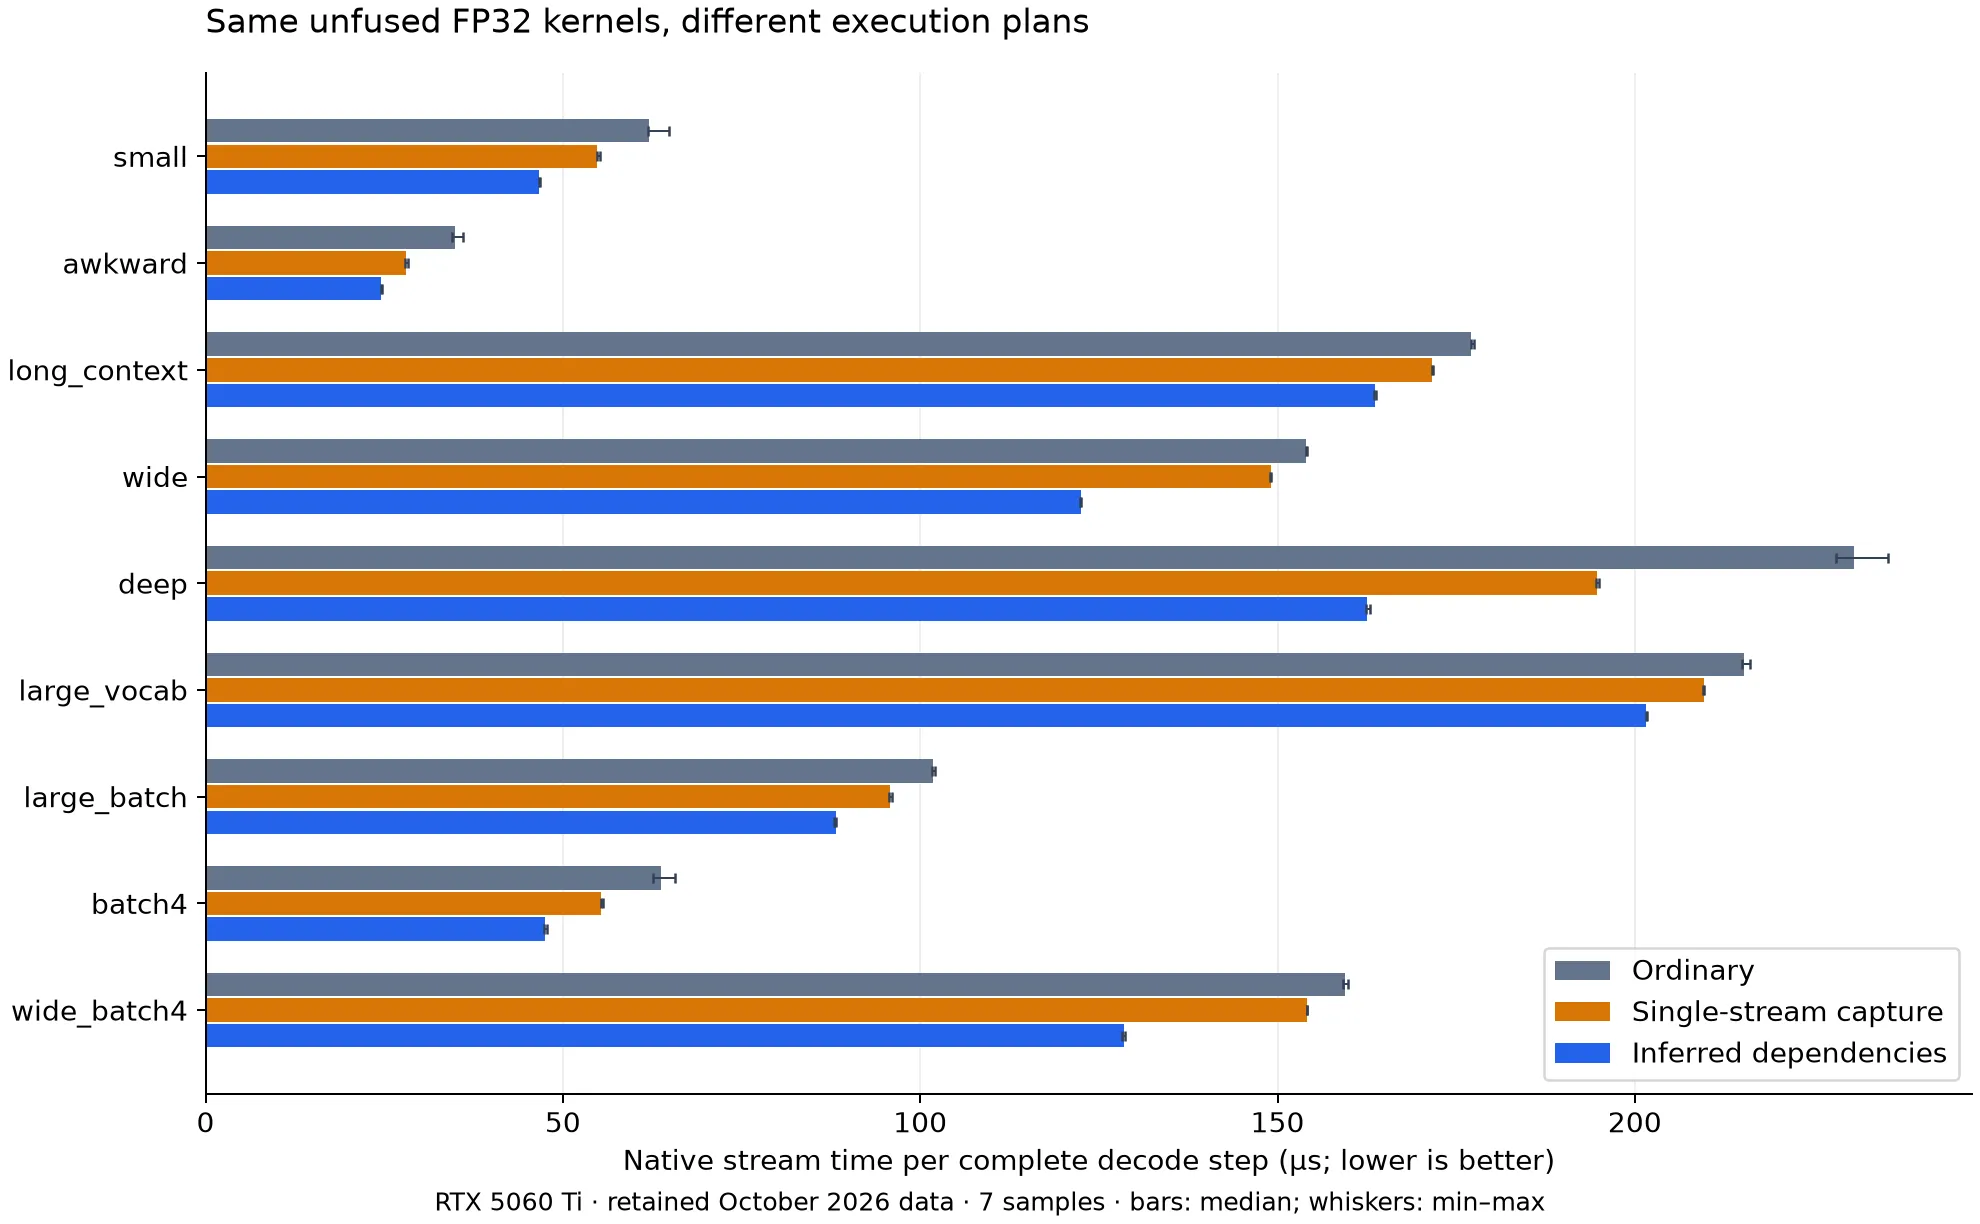
普通执行对比 capture 展示单 stream 顺序下图重放的价值;capture 对比推导图,则检验已有重放后,编译器推导依赖能否进一步受益。九组用例再改善 1.04–1.22×,small 每步约省 8 微秒,wide 约 27 微秒。八层模型在更多层重复利用调度机会,比 capture 改善 1.20×。
对照让归因更清楚:CUDA Graph 重放提供通用运行时收益,CKL 提供限制更少的依赖图。接下来要检查 GPU 是否真正重叠执行独立工作。
有效的场景
下图展示 Nsight Systems 记录的 CUDA 活动,每个矩形代表一段 kernel 执行区间。
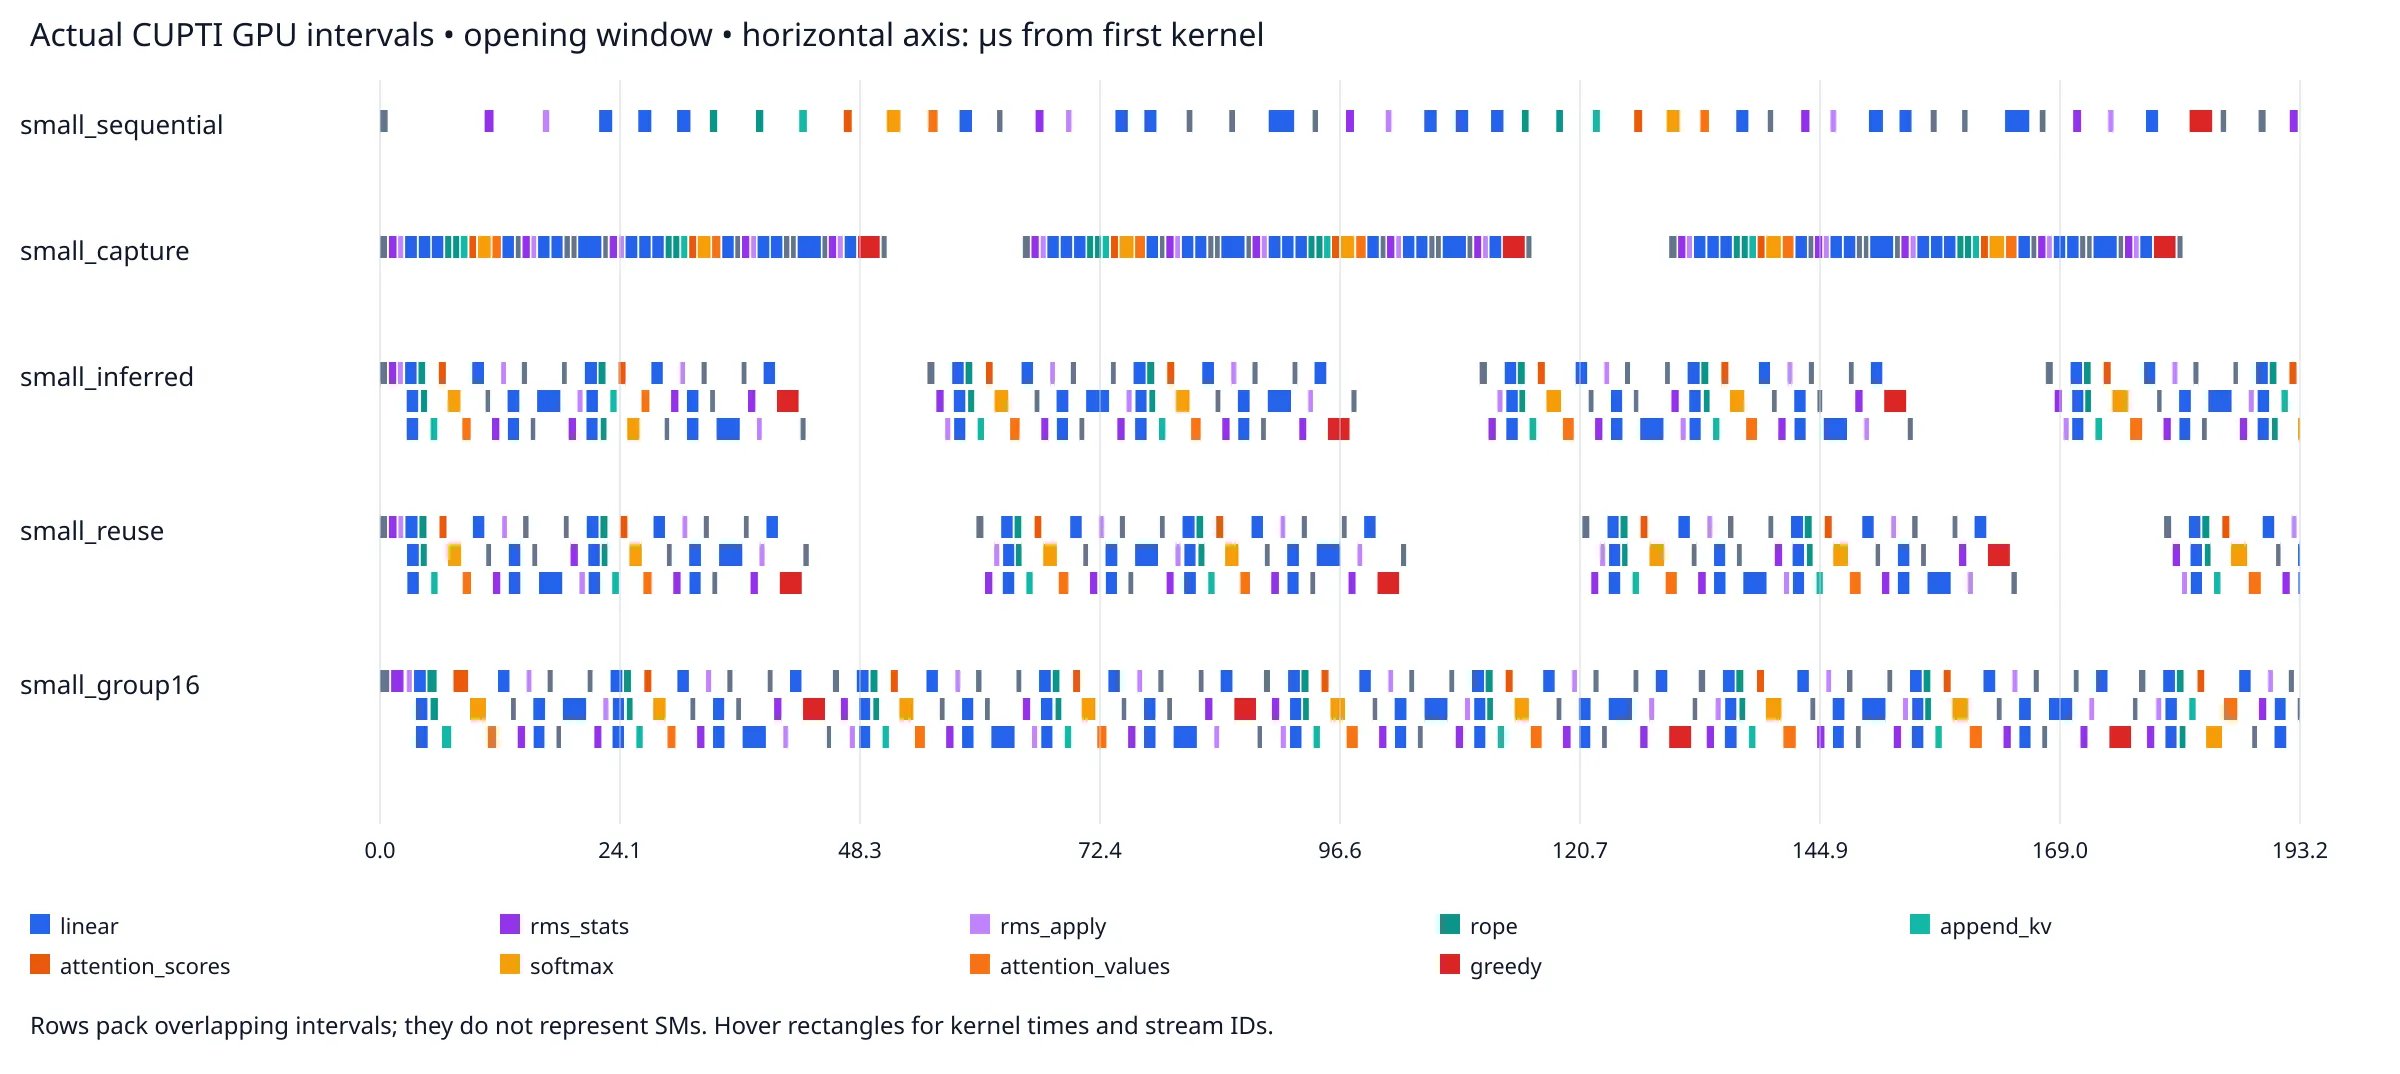
小模型:capture 减少提交开销,但仍串行执行 kernel。推导图暴露 Q/K/V 与 gate/up 投影的重叠,存储复用保留了重叠机会。
Q、K、V 都读取归一化隐藏状态,写入独立输出。各自消费者需要相应结果,但三个投影彼此无需等待。MLP 的 gate 与 up 投影也类似。普通和 capture 轨迹没有重叠 kernel;推导轨迹最多同时出现三个,至少两个活跃 kernel 的区间占记录 GPU 跨度的 9.5%。
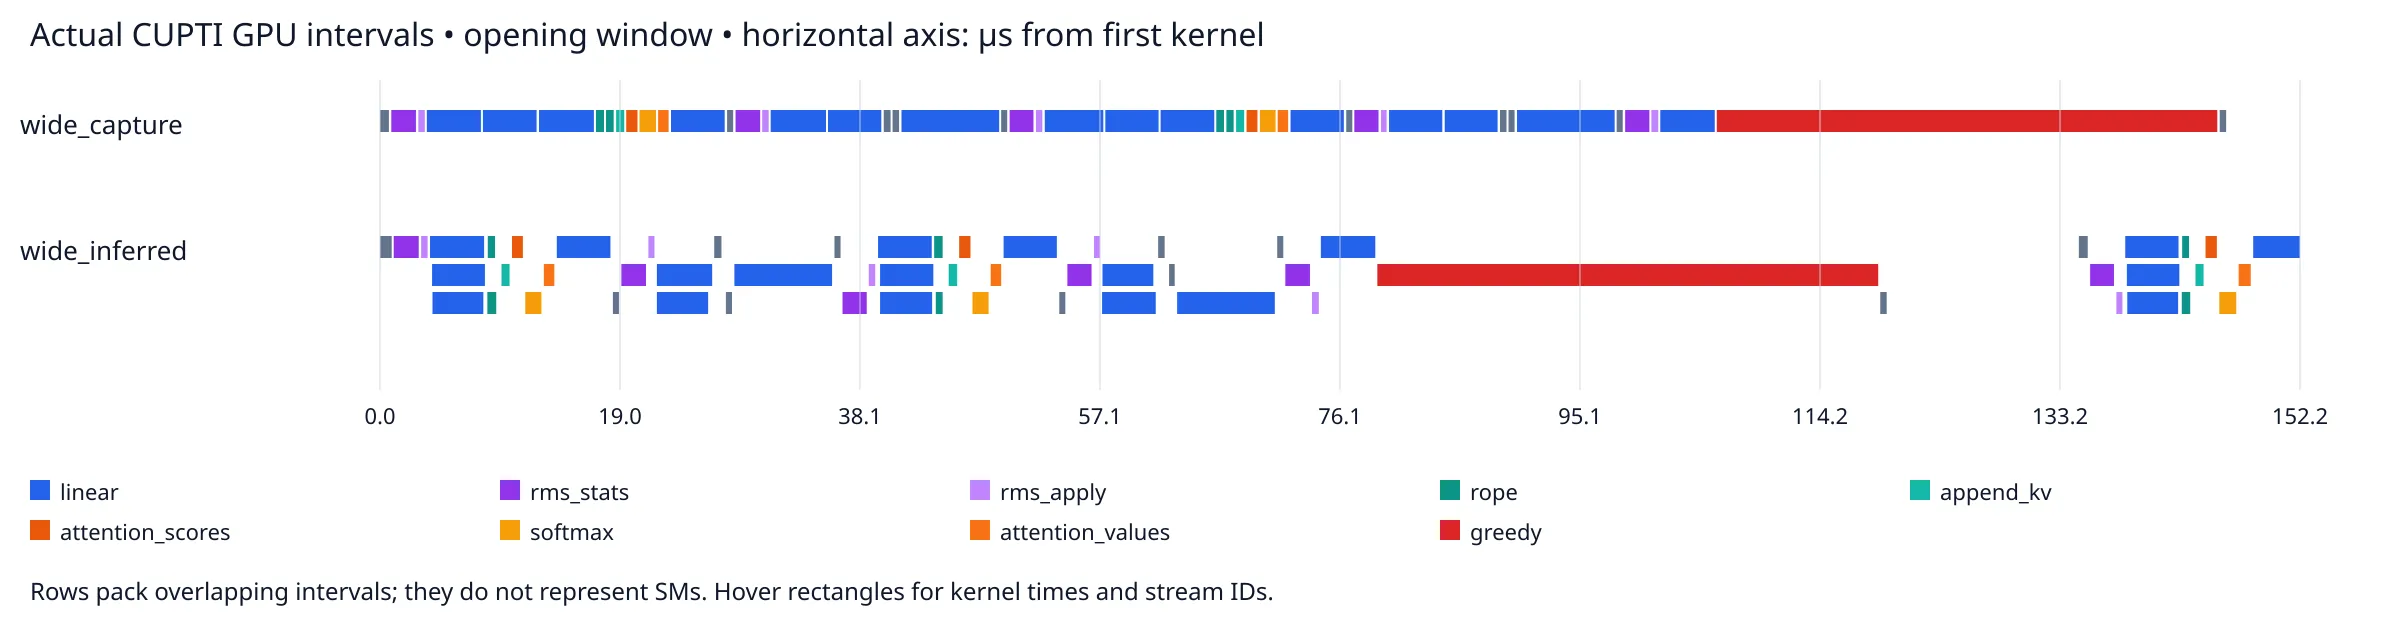
较宽模型:独立投影各持续约 4 微秒,因此重叠比小模型更有价值。
wide 中,capture 与推导执行的 kernel 耗时总和接近,但执行区间并集缩短,支持调度重叠是收益来源。原 kernel 仍照常执行,设备代码没有因融合而加速。
轨迹计数提供另一项检查:
| 小模型分析 | 主机 Kernel / Graph 启动 | Kernel 执行次数 | 至少两个 Kernel 活跃的跨度 | 最大并发 Kernel |
|---|---|---|---|---|
| 普通 | 768 / 0 | 768 | 0.0% | 1 |
| Capture | 0 / 16 | 768 | 0.0% | 1 |
| 推导图 | 0 / 16 | 768 | 9.5% | 3 |
| 推导图 + 复用 | 0 / 16 | 768 | 9.3% | 3 |
| 推导图,16 步分组 | 0 / 1 | 768 | 11.9% | 3 |
每种方式仍是 48 个 kernel × 16 步。重放改变主机提交数,推导依赖改变合法调度,分组进一步减少图提交。
收益有限的场景
长上下文和大词表暴露了解码依赖路径上单个 kernel 的瓶颈,调度层无法为这些串行依赖创造并行。
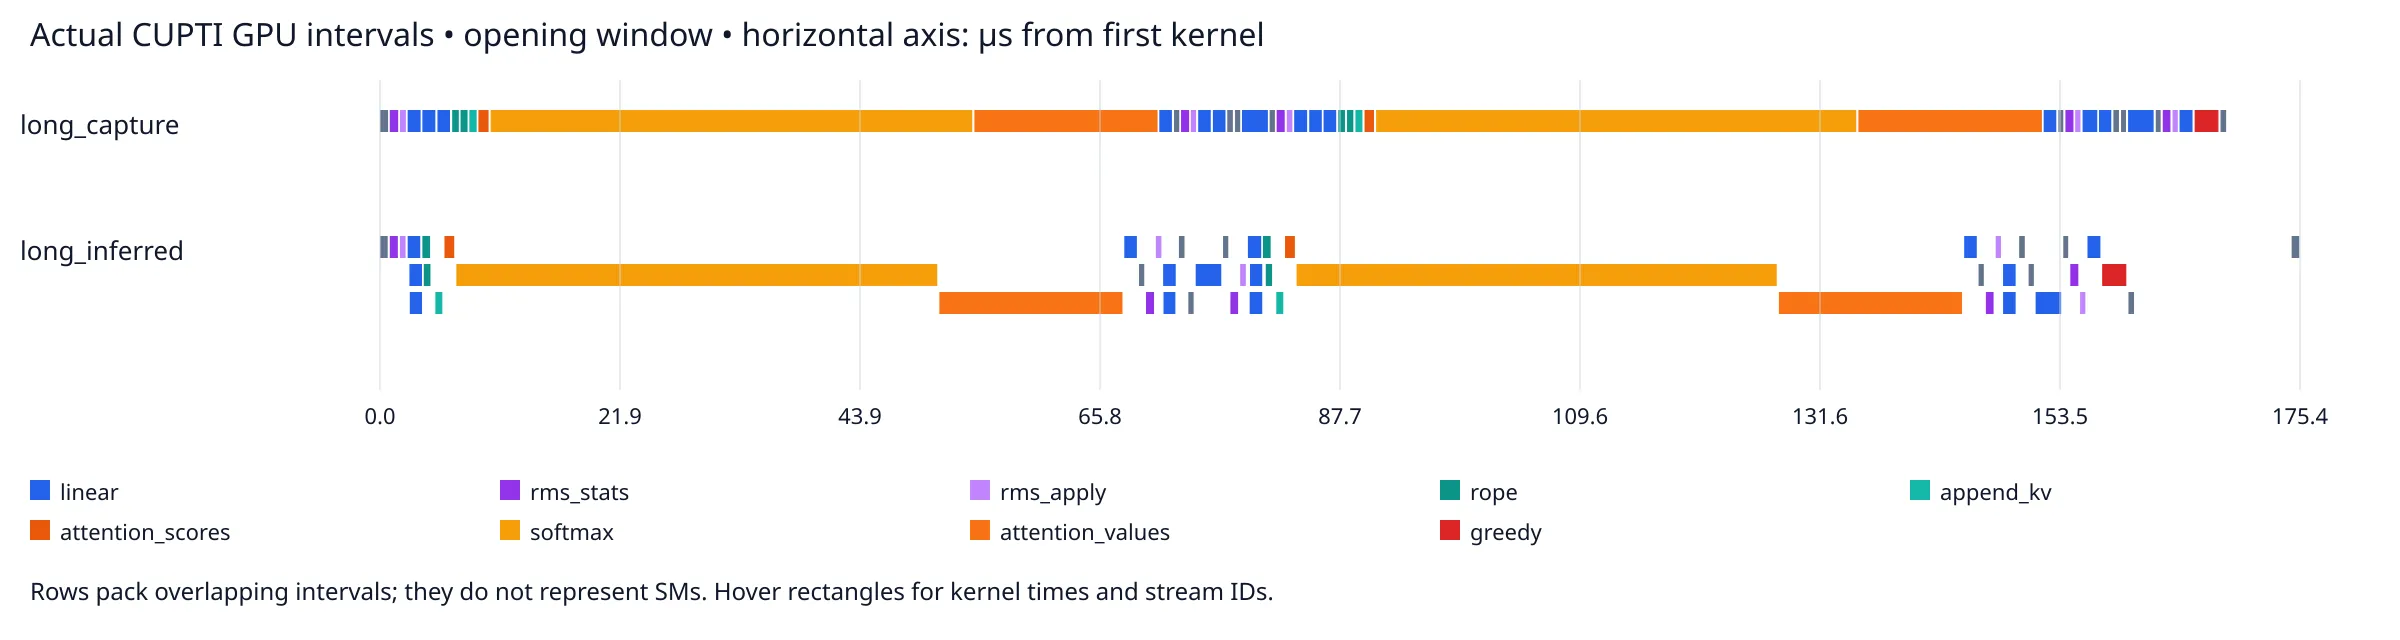
上下文 512:Softmax 主导已记录的 kernel 工作,限制投影重叠能节省的时间。
历史长上下文记录中,softmax 占 kernel 总时间的 54.9%,每完整步骤 89.1 微秒。其串行归约完成后 attention 才能继续。CKL 仍暴露独立投影,但相比 capture 只改善约 5%。
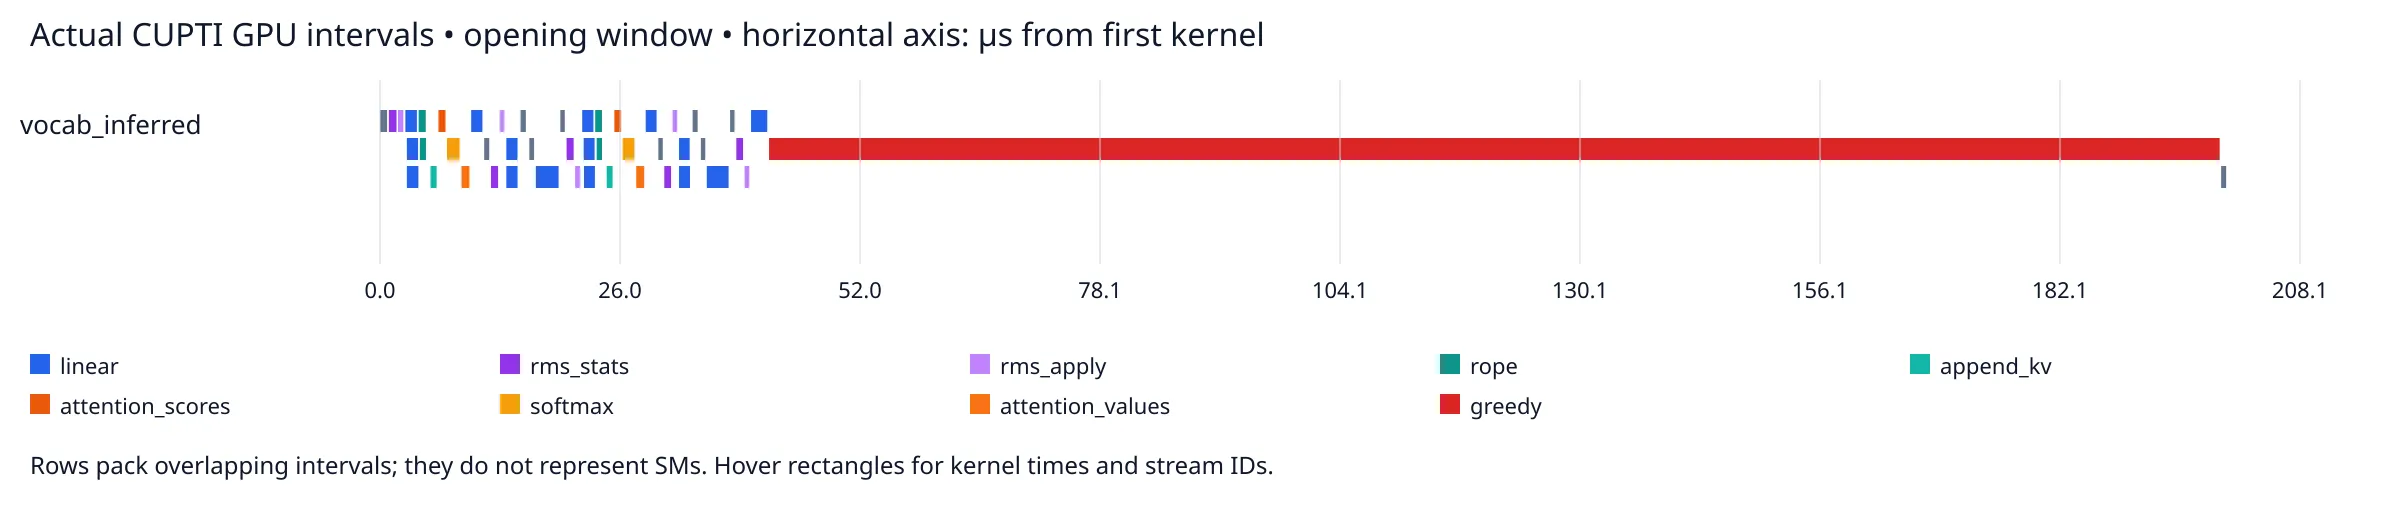
词表 8192:贪心选择成为下一个 token 反馈前的主要串行依赖。
这里 greedy 占 kernel 总时间的 78.4%,每完整步骤 157.1 微秒,相比 capture 仅改善约 4%。这些百分比来自已分析 kernel 耗时总和,不是未分析时的墙钟时间占比,但仍清楚指出 kernel 内部工作主导了成本。
这给出具体编译器方向:改善通用并行归约,以及 CKL 的 Softmax 和选择实现,再运行相同未融合对照。现有记录解释了动机,并未测量后续归约改动的效果。下一阶段依赖串行归约结果时,依赖调度无法消除它。
存储复用
| 用例 | 不复用 Scratch | 复用 Scratch | 降幅 |
|---|---|---|---|
| small | 14,080 B | 3,072 B | 78.2% |
| wide | 47,360 B | 10,240 B | 78.4% |
| deep | 54,016 B | 3,072 B | 94.3% |
| large_batch | 1,017,088 B | 294,912 B | 71.0% |
deep 很有代表性:层数更多,每步 174 次 dispatch,但有序临时生命周期让规划器跨层复用小型 scratch heap。节省不包含只读权重、持久 KV cache、token 历史和 logits,因此不等于模型总内存降幅。
普通、capture、推导的匹配对照表明复用几乎不改变时间。例如 small 推导执行不复用为 46.71 微秒/步,复用为 46.88。证据支持容量收益,不支持延迟收益。规划器保持图拓扑,不会为强制更多复用而串行化。
步骤分组
group4_inferred 将连续四个解码步骤放入一次推导图提交。每步消费前一步的 token 和更新状态,仍是每请求每步生成一个 token。改变的是主机提交与观察完成的频率。
| 每次推导提交的步数,小模型 | 原生 µs/步 | Python 16 步完成 ms | 图构建 ms | 每序列提交次数 |
|---|---|---|---|---|
| 1 | 46.88 | 0.804 | 0.129 | 16 |
| 2 | 45.81 | 0.763 | 0.327 | 8 |
| 4 | 45.60 | 0.744 | 0.740 | 4 |
| 8 | 45.49 | 0.735 | 1.448 | 2 |
| 16 | 45.40 | 0.731 | 2.887 | 1 |
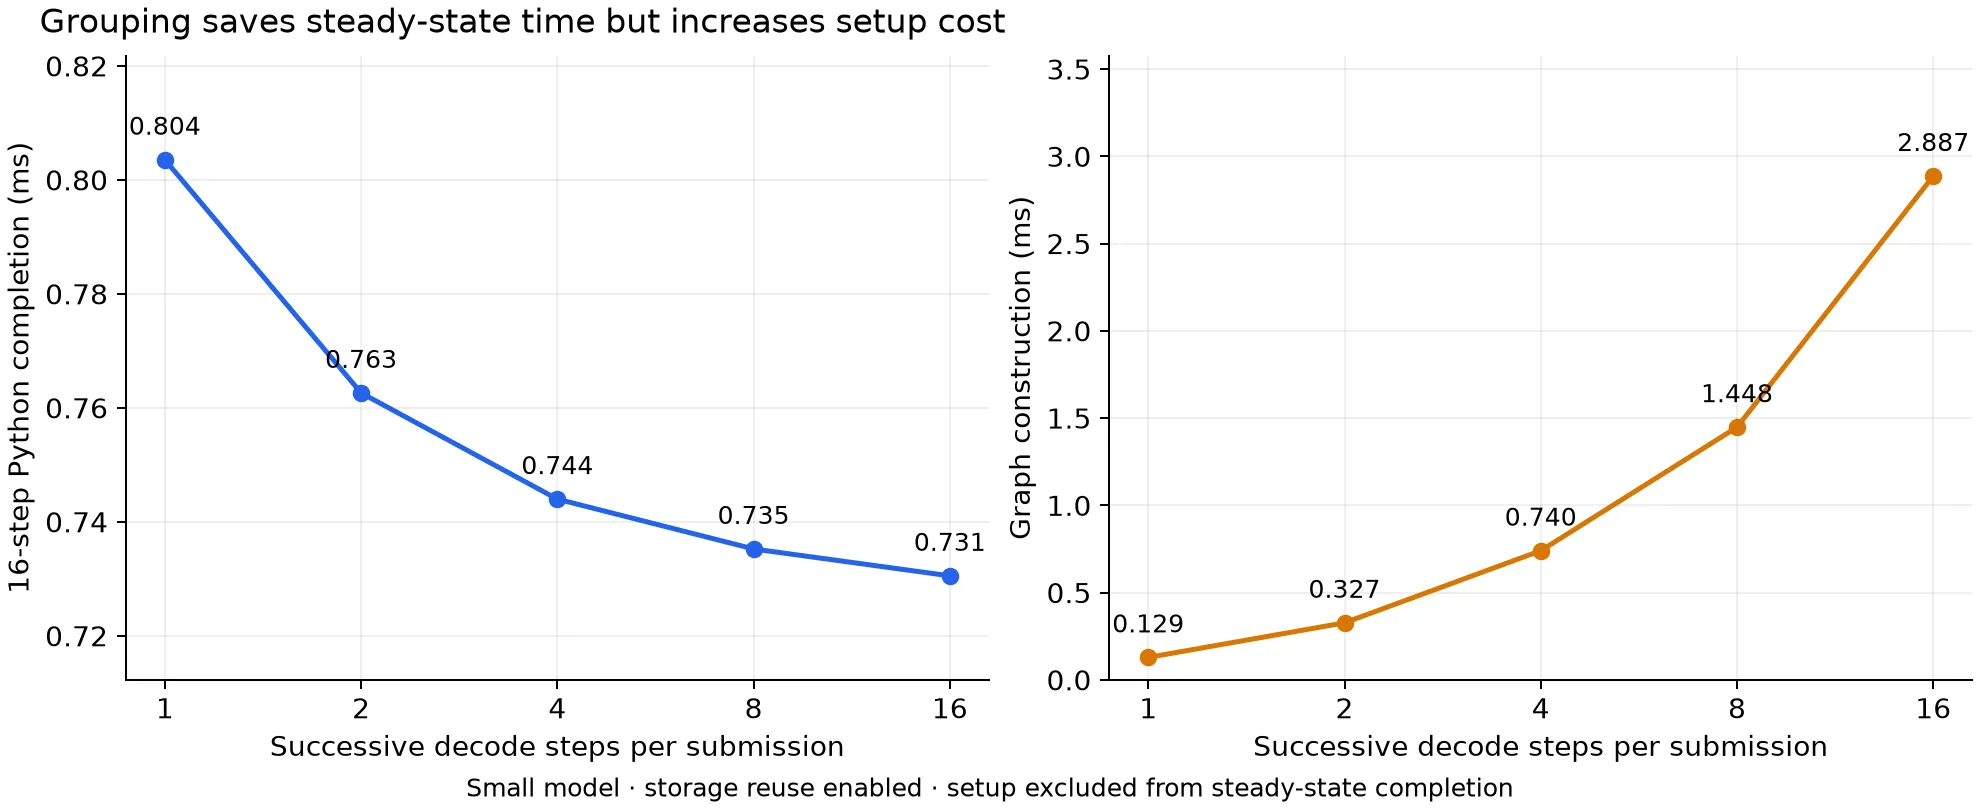
最大收益在每组二到四步时出现。继续增大图,稳定执行收益递减,构建成本上升。相比单步推导图,16 步分组每序列省约 0.073 ms,却增加约 2.758 ms 构建成本。在相同绑定图可复用的假设下,需要约 38 次重复序列收回成本,尚不计编译和绑定。deep 的 2,784 节点分组图构建耗时 11.16 ms。
普通逐步调用对比 16 步推导图,Python 生成完成时间在 small 上改善 1.48×,wide 上改善 1.31×。它们同时包含调度收益,以及减少 Python 调用和完成等待的收益。
局限性
与完整调度器相比,CKL 仍缺少:
- 更细粒度的 subview 和别名支持,以挖掘更多并行。
- 主机侧异步程序,以组合多个程序;目前只能优化单个程序,且主机视角下程序同步执行。
- 更完善的资源模型。资源争用会削弱编排收益,并发过高甚至可能降低整体性能。