最初理解 im2col 时觉得很绕,这里记录一下自己的思考过程。
IM2COL 的动机
卷积自然表达为滑动窗口:对每个输出位置,从输入中收集一个小邻域,再与卷积核求内积。这个描述直观,却不一定最适合现代加速器。GPU 尤其擅长稠密矩阵乘法,较大的 GEMM 很容易映射到 tensor core;朴素卷积循环则暴露为许多带复杂索引的小点积。
IM2COL 连接了两种表达:将每个滑动窗口物化或逻辑地视为矩阵的一行,再把卷积核展平为另一个矩阵,于是卷积变为 GEMM:
数学计算没有改变,改变的是工作布局。GEMM 为编译器和硬件提供了更清晰的结构:连续 tile、可预测的数据搬运、共享内存复用和适合 tensor core 的矩阵 fragment。即使不把完整 im2col 矩阵写到全局内存,分块 kernel 也常采用相同思路:暂存局部输入区域,重排为 GEMM 需要的矩阵形状,完成乘法后再重排结果。
代价是 im2col 可能复制输入元素。相邻窗口重叠,同一输入值可能出现在展开矩阵的多行中。直接物化会增加带宽和存储成本。优化实现通常在 tile 内或共享内存中进行展开,以获得 GEMM 友好的结构,又避免完整全局物化的成本。
IM2COL
TileLang 中的 im2col 很简单:
@tilelang.jit(
    pass_configs={
        tilelang.PassConfigKey.TL_DISABLE_WARP_SPECIALIZED: True,
        tilelang.PassConfigKey.TL_DISABLE_TMA_LOWER: True,
    },
)
def tl_conv1d_im2col(X, K, BLOCK_N: int, BLOCK_L: int):
    N, L, KL, F = T.const("N, L, KL, F")
    dtype = T.float16
    accum_dtype = T.float32
    X: T.Tensor((N, L), dtype)
    K: T.Tensor((KL, F), dtype)
    O = T.empty((N, L, F), dtype)

    with T.Kernel(N // BLOCK_N, L // BLOCK_L, threads=256) as (pid_n, pid_l):
        X_shared = T.alloc_shared((BLOCK_N, BLOCK_L, KL), dtype)
        K_shared = T.alloc_shared((KL, F), dtype)
        O_local = T.alloc_fragment((BLOCK_N * BLOCK_L, F), accum_dtype)

        for i, j, k in T.Parallel(BLOCK_N, BLOCK_L, KL):
            X_shared[i, j, k] = T.if_then_else(
                pid_l * BLOCK_L + j + k < L, X[pid_n * BLOCK_N + i, pid_l * BLOCK_L + j + k], 0
            )
        X_reshaped = T.reshape(X_shared, (BLOCK_N * BLOCK_L, KL))
        T.copy(K, K_shared)
        T.gemm(X_reshaped, K_shared, O_local, clear_accum=True)
        O_reshaped = T.reshape(O_local, (BLOCK_N, BLOCK_L, F))
        T.copy(O_reshaped, O[pid_n * BLOCK_N, pid_l * BLOCK_L, 0])
    return O
基本步骤是:
- 展平 X。
- 重塑 X。
- GEMM。
- 将 O 重塑回原形状。
- 写回。
最小示例中,输入 X 形状为 (N, L),卷积核 K 为 (KL, F)。F 是输出通道维度,可以对不同通道重复相同运算,因此先忽略它,将问题理解为沿 X 的 L 维进行一维卷积。
直观上,让卷积核扫过输入,输出为 。它与两个向量的内积很相似。
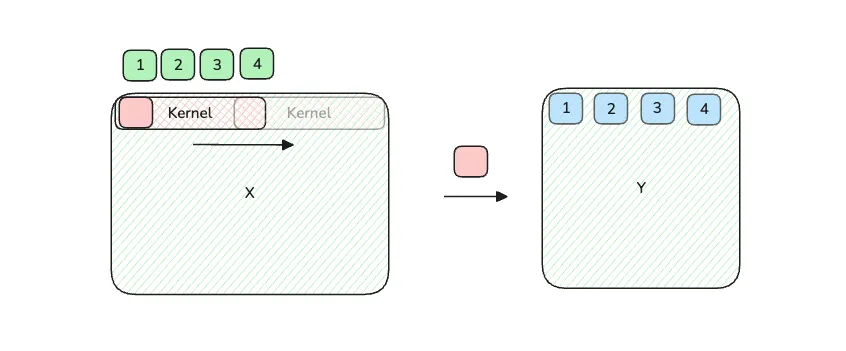
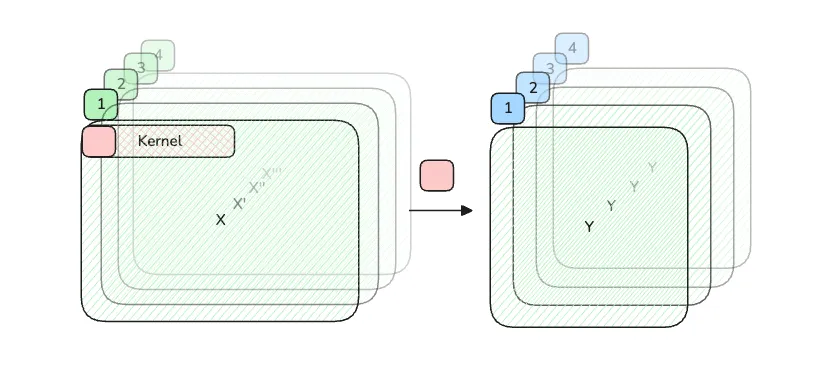
关键是把“滑动”展开成额外一个维度,该维度的每层都记录卷积核某一时刻看到的矩阵快照。卷积核长度为 4 时,t=0 看到第 1、2、3、4 个元素,t=1 看到第 2、3、4、5 个元素。这里沿用图中的 1 起始编号。对于窗口内第一个位置,不同时刻依次对应第 1、2、3……个元素。扩展新维度后,整个滑动过程就变成一张由快照组成的大矩阵。
将扩展矩阵的内部维度重塑,就能清楚看到它与矩阵乘法等价。
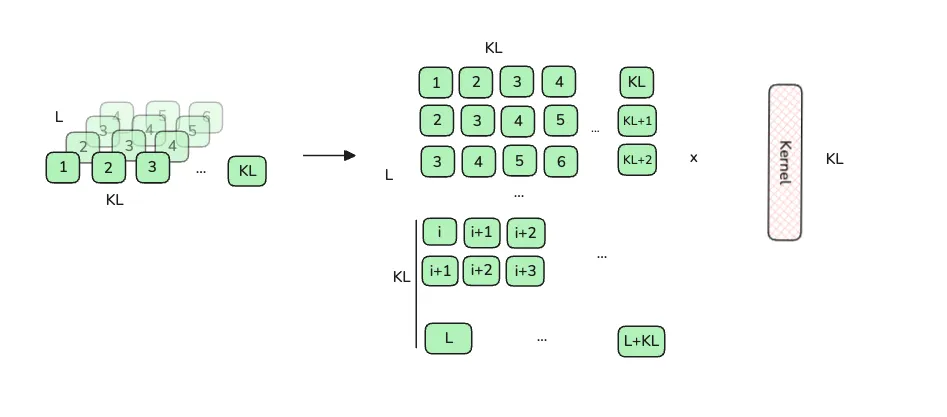 分块后,内部 tile 与尾部 tile 不同。内部 tile 不必刻意检查整个输入的边界;尾部 tile 则必须确保滑动窗口不超出真实输入,并用 mask 处理。
图中元素索引可以超出 L,因为 tile 语境下这里的 L 实际是 BLOCK_L。当前 tile 之外的输入也可能贡献当前 tile 的输出。
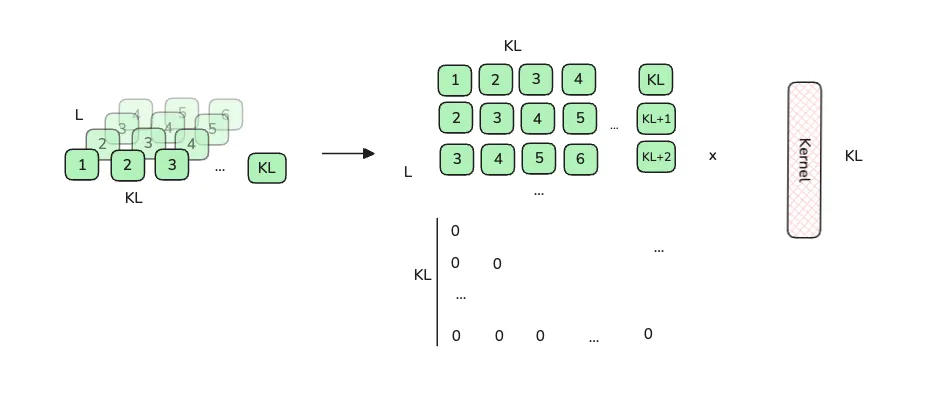
但如果来到最后一个 block,超过真实 L 的索引就必须补 0,因为它们确实越界了。